llama-bench-helper
llama.cpp 向けのベンチマーク補助 CLI です。モデルの入手、速度計測、品質確認を、予め設定した内容で回し、結果を出力します。
githubリポジトリ:https://github.com/iiiorz/llama-bench-helper
llama-bench-helper でできること
llama-bench-helper(以下lbh) は、次の流れをまとめて面倒をみる CLI ツールです。
モデルの入手 → 速度計測 → 品質確認 → 結果のまとめ
機能
- download ― Hugging Face の URL を渡すとファイル一覧とサイズが表示され、選んだものを
hf downloadで取得します。GGUF ファイルを含まないリポジトリでは「llama.cpp ではそのまま使えません」と警告が出ます。画像入力用の mmproj ファイルがあれば、一緒に取得するか提案もします - bench ― 複数モデルを連続で llama-bench にかけます。実行前に VRAM の見積もりが GPU の総量を超えそうだな場合は警告し、実行中は VRAM使用量 を 1 秒間隔で記録、結果は指定回数繰り返しの中央値で集計します
- quality ― 共通プロンプトを全モデルに同じ条件で実行します。文字数や指定語の出現回数といった「数えられる条件」は機械チェックで自動判定します。画像プロンプトは、mmproj が対応付いたモデルでのみ実行されます
- export / report ― 結果をブログなどに貼れる Markdown 表にまとめます。さらに、品質確認においてプロンプトと全モデルの回答を1ファイルに同梱した「AI 評価用バンドル」を出力します。そのまま ChatGPT や Claude に渡して採点してもらってください。
動作環境
- Python 3.11 以上 llama.cpp のビルド済みバイナリ(
llama-bench/llama-server) - Hugging Face CLI(
hf、ダウンロード機能を使う場合) - NVIDIA GPU +
nvidia-smi(VRAM 記録を使う場合。無くても計測自体は動きます) - Windows / Linux / macOS
導入手順
前提は、Python 3.11 以上、llama.cpp のバイナリ(llama-bench / llama-server)、ダウンロード機能を使う場合は Hugging Face CLI(hf)、そして NVIDIA GPU です。llama.cpp の導入自体は以前の記事を参考にしてください。
git clone https://github.com/iiiorz/llama-bench-helper.git
cd llama-bench-helper
python -m pip install.
lbh init
lbh init で設定ファイル config.toml と models.toml の雛形が作られます。config.toml は全項目にコメントで説明が付いています。まずは [paths] の llama.cpp の場所とモデルの置き場所のpathを指定してください。
[paths] #pathは例
llama_bin = "C:/tools/llama.cpp/b11960"
models_dir = "C:/tools/llama.cpp/models"
results_dir = "C:/tools/llama.cpp/results"
models.toml は「モデルごとの差分」だけを書く場所です。たとえば第2弾で部分オフロードが必要だった Qwen3-Coder には -ncmoe 12 を、画像対応の Qwen3-VL には mmproj の対応付けを、という具合です。差分がないモデルは書く必要はありません。指定したmodels_dir内の GGUF が自動で検出されます。
[[model]]
file = "Qwen3-Coder-30B-A3B-Instruct-Q4_K_M.gguf"
extra_bench_args = ["-ncmoe", "12"]
extra_server_args = ["-ncmoe", "12"]

# 例: 画像入力に対応するモデルは mmproj を対応付けます。
# mmproj が登録されたモデルだけ、品質測定で画像プロンプトが実行されます。
[[model]]
file = "Qwen3VL-8B-Instruct-Q4_K_M.gguf"
mmproj = "mmproj-Qwen3VL-8B-Instruct-F16.gguf"
vision = true使い方
引数なしで lbh と打つと対話メニューが開きます。サブコマンドでも直接実行できます。
モデルを入手する ― lbh download
lbh download https://huggingface.co/Qwen/Qwen3-14B-GGUF
自身でモデルを取得して当該ディレクトリに保存してももちろん良いですが、ダウンロード機能を付けました。
URL を貼ると、リポジトリ内のファイルがサイズつきで一覧表示されます。番号で選ぶと合計サイズと空き容量を確認してからダウンロードが始まり、終わるとサイズ検証と SHA256 の記録(マニフェスト)が残ります。「どのリポジトリの、どのファイルを、いつ取ったか」が後から辿れるのが地味に大事です。
モデルはlbh modelsと打ち込めば、指定したディレクトリ内のモデルが一覧表示されます。このとき、models.tomlの内容も参照されます。
速度を測る ― lbh bench
lbh bench --models Qwen3-14B-Q4_K_M,Qwen3-14B-Q8_0,gpt-oss-20b,Qwen3-Coder,Qwen3VL
指定したモデルを順番に llama-bench で計測します。条件の既定値は第2弾と同じ(pp512 / tg128、3 回の中央値、KV キャッシュは q8_0)で、変えたい場合はオプションや設定ファイルで変更できます。結果は実行ごとに日時フォルダが生成され、 CSV で保存されます。
VRAM の事前警告も出る場合があります。例えば、Qwen3 14B の Q8_0 は、ファイルサイズと KV キャッシュから見積もると 16 GB を少し超えるため、VRAMが16GB以下であれば実行前に警告が出ます。実際には 8K コンテキストでもピーク で収まったりしますが、見積もりは安全側に倒してある、という設計です。警告は止めるためのものではなく、「部分オフロードを検討するか、そのまま行くか」を選ぶためのものになっています。
品質を確認する ― lbh quality
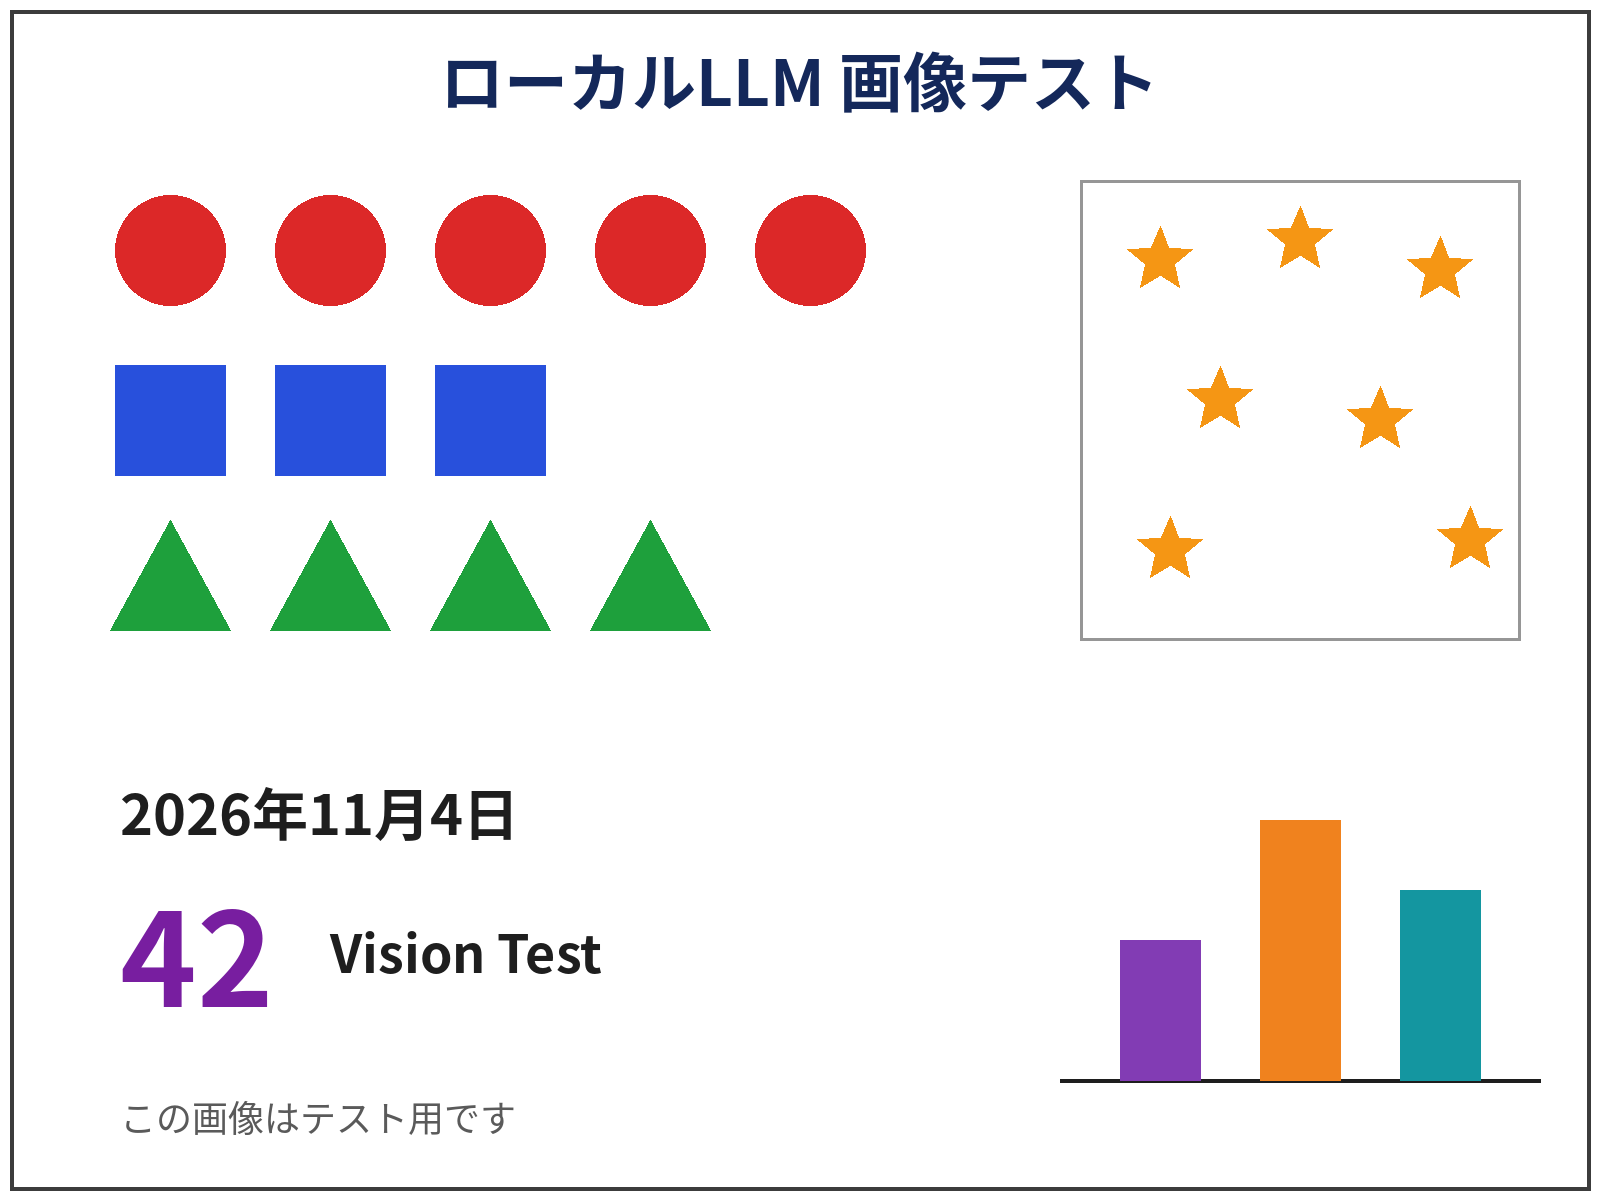
lbh quality --models Qwen3-14B-Q4_K_M,Qwen3-14B-Q8_0,gpt-oss-20b,Qwen3-Coder,Qwen3VL --image samples/vl-test-image.png
llama-server の起動から、プロンプトの実行、サーバーの停止までをモデルごとに自動で回します。サーバーが応答可能になるまでの時間も、ロード時間として一緒に記録されます。
同梱の既定プロンプトは以前使ったもの(要約、コード生成、論理パズル、制約つき長文、既定温度のサンプル、画像読み取り)で以下の内容が入っています。JSON ファイルを編集すれば文面も条件も差し替えられます。画像読み取り用のテスト画像と正解表は、リポジトリの samples/ フォルダに入れてあります。図形の数や文字が確定している画像なので、読み取り結果を正解表と照らして採点できます。
- P1:要約
- P2: コード
- P3: 論理パズル
- P4: 長文指示
- デフォルト温度
- 画像(Qwen3-VLのみ)
次の文章を、重要な数字を落とさずに、3文以内・200字以内で要約してください。
横浜市は2027年4月、市中央図書館のリニューアルオープンを発表した。改修工事は2025年10月から17か月かけて行われ、総事業費は約48億円。改修の中心は3つある。第1に、蔵書スペースを従来の1.4倍に拡張し、開架冊数を32万冊から45万冊に増やした。第2に、3階に120席の学習室を新設し、うち40席は予約制の個室ブースとした。第3に、1階にカフェと子ども向けの読み聞かせスペースを併設し、開館時間を平日は午前9時から午後9時まで、土日祝日は午前9時30分から午後6時まで延長した。市は、年間の来館者数が改修前の約78万人から110万人に増えると見込んでいる。一方で、駐車場は改修前と同じ85台分しかなく、市は公共交通機関の利用を呼びかけている。
Pythonで、リストを受け取り、重複する要素を取り除いて元の順序のまま返す関数 unique_items(items) を書いてください。条件は次のとおりです。
・型ヒントとdocstringを付けること
・集合(set)を使ってよいが、順序が保たれること
・最後に、使用例とその実行結果を示すこと
3つの箱があります。ラベルにはそれぞれ「金貨だけ」「銀貨だけ」「金貨と銀貨」と書かれていますが、すべてのラベルは間違っています。中身は、金貨だけの箱、銀貨だけの箱、金貨と銀貨が混ざった箱が1つずつです。どれか1つの箱から硬貨を1枚だけ取り出して見ることで、すべての箱の中身を確定できます。どの箱から取り出すべきか、そして取り出した硬貨が金貨だった場合、各箱の中身がどう確定するか、順を追って説明してください。
在宅勤務のメリットについて、次の条件をすべて守って書いてください。
(1) 全体を2つの見出し「## メリット」「## 注意点」で構成すること
(2) 「## メリット」の下には箇条書きでちょうど3点挙げ、各項目は40字以内にすること
(3) 「通勤」という言葉を、全体で必ず1回だけ使うこと
(4) 最後は、注意点をふまえた一文の結論で締めること
(5) 全体で400字以内にすること
今度の週末、丸一日フリーになりました。家の中でできる、あまりお金のかからない面白い過ごし方を3つ提案してください。それぞれ、所要時間の目安も添えてください。
この画像に写っているものを詳しく説明してください。数えられるものがあれば個数も教えてください。
機械チェックの例として、制約つき長文のプロンプトには「『通勤』という語を全体でちょうど1回だけ使うこと」という条件があり、こういう条件は目視だと見落とします。lbh では、文字数の上限、文の数、指定語の出現回数、箇条書きの数といったチェックをプロンプト定義に書いておけば、実行と同時に合否が付きます。ただ、これはあくまで機械的な判定なので、評価は次項のようにAIに任せたりすると良いと思います。
回答を AI に採点させる ― lbh export
品質測定が終わると、ai-eval-bundle.md というファイルが自動で生成されます。中身は、評価者への指示文、プロンプトごとの評価観点、全モデルのプロンプトと回答、そして機械チェックの結果です。これと、画像を使用した場合は画像を他の AI(ChatGPT や Claude など)に渡すと、たぶん総評を返してくれるはずです。
モデル名を伏せて採点させたい場合は、匿名化オプションもあります。
lbh export --anonymize
この場合、回答は Model A / Model B … と表記され、対応表は別ファイルに分かれます。名前で先入観が入るのを避けたいときにどうぞ。
Sonnet 5.5による総評の例(抜粋)
評価点の表などは省略して結果総評だけ抜粋です。
モデルごとの総評

Qwen3-14B-Q4_K_M
大きな破綻がなく、全体的に安定しています。コードと論理パズルは正確でした。一方で、文数や「通勤」1回といった細かい数値制約は守れていません。

Qwen3-14B-Q8_0
内容の質はQ4とほぼ同等で、論理パズルの説明は少し丁寧でした。今回はQ8にしても明確な向上は見られず、defaultでは出力が途中で切れています。同じ制約違反も繰り返しました。

Qwen3-Coder-30B-A3B
今回の総合で最も安定しており、制約遵守と日本語の自然さが強みです。p4を唯一完全クリアし、コードも最良でした。弱点は、要約で数字を落としやすい点と、論理パズルの途中説明に誤りが混じる点です。

Qwen3VL-8B
コードは良好で、画像理解も試せる点は強みです。一方で、p3のループ崩壊、p1の英語混入、p4の違反と、テキスト単体の安定性が低めでした。繰り返し抑制の設定が必要そうです。

gpt-oss-20b
うまくいったときは非常に強く、p2とp3は最良級でした。p1では数字を最も網羅しています。ただし、defaultの途中切れ、p4の思考過程の露出と暴走、と出力が不安定です。

用途別のおすすめ
日本語の文章作成・指示や制約に厳密に従わせる用途: Qwen3-Coder-30B。
コード生成・論理推論: gpt-oss-20b か Qwen3-Coder-30B。gpt-oss-20b は上限トークンや思考過程の出し方の設定を見直し、思考過程が漏れても使える運用が前提です。
軽量で安定した汎用チャット: Qwen3-14B-Q4_K_M。Q8にしても今回は利点がほぼなく、Q4で十分です。
画像を扱う用途: Qwen3VL-8B。ただしテキスト中心のタスクには向きません。
結果を表にする ― lbh report
lbh report
最新の実行結果から、速度・VRAM・ロード時間と品質チェックの状態をまとめた Markdown の表が生成されます。記事の下書き等として、ご活用ください。
注意点
- VRAM の事前見積もりは安全側に寄せた概算です。実測で収まる場合にも警告が出ます(Q8_0 の例のとおり)。最終判断は実測で
- 機械チェックができるのは「数えられる条件」だけです。内容の正しさや文章の良し悪しは、AI 採点や目視の領分です
- OS に依存しない作りにはしていますが、動かない場合があるかもしれません
- 回答に含まれるコードを自動実行して検証する機能は、あえて既定で無効にしています。モデルの出力は信頼できないコードなので、使う場合は明示的に有効化してください
まとめ
ベンチマークは、測り方を固定して初めて「比較」になります。その固定と記録を補助できればと思います。
※ 本記事の内容は 2026 年 11 月 4 日時点のものです。ツールのバージョンは v0.1.0 を対象にしています。