llama.cppを使いVRAM 16GB の環境で 5 つのモデルを動かし、処理速度・VRAM 使用量・ロード時間に加えて、共通プロンプトによる回答品質まで計測していきます。
計測の前提と方法
計測環境は次のとおりです。
| 項目 | 内容 |
|---|---|
| GPU | RTX 4070 Ti Super(VRAM 16GB) |
| CPU | AMD Ryzen 9 9950X |
| メモリ | 64GB |
| llama.cpp | b11960(v0.8.0 相当)CUDA 13.4 版 |
| OS | Windows11Pro (26H2) |
対象モデルは以下の 5 つです。
| モデル | 量子化 | ファイルサイズ |
|---|---|---|
| Qwen3 14B | Q4_K_M | 約 9.0GB |
| Qwen3 14B | Q8_0 | 約 15.7GB |
| gpt-oss-20b | MXFP4 | 約 12.1GB |
| Qwen3-Coder 30B A3B | Q4_K_M(部分オフロード) | 約 18.6GB |
| Qwen3-VL 8B | Q4_K_M(+画像用 mmproj 約 1.2GB) | 約 5.0GB |
計測方法は次のとおりです。
- 速度は llama-bench で、プロンプト処理 pp512 と生成 tg128 を各 3 回測り、中央値を採用しました
- VRAM は生成中のピーク値を、nvidia-smi で 1 秒間隔に記録して求めました
- 共通条件は、全レイヤーを GPU に載せる
-ngl 99、Flash Attention 有効、KV キャッシュの量子化 q8_0 です - Qwen3-Coder だけはモデルが VRAM に収まらないため、MoE の一部を CPU 側に逃がす
-ncmoe 12で計測しました(決め方は VRAM の章で触れます) - 品質確認は llama-server(コンテキスト 8192)を使い、共通プロンプト 4 題を温度 0 で投げました。ほかにデフォルト温度のサンプル 1 題と、Qwen3-VL には画像の読み取り 1 題を追加しています

速度の結果 ― gpt-oss の圧勝と、量子化の代償
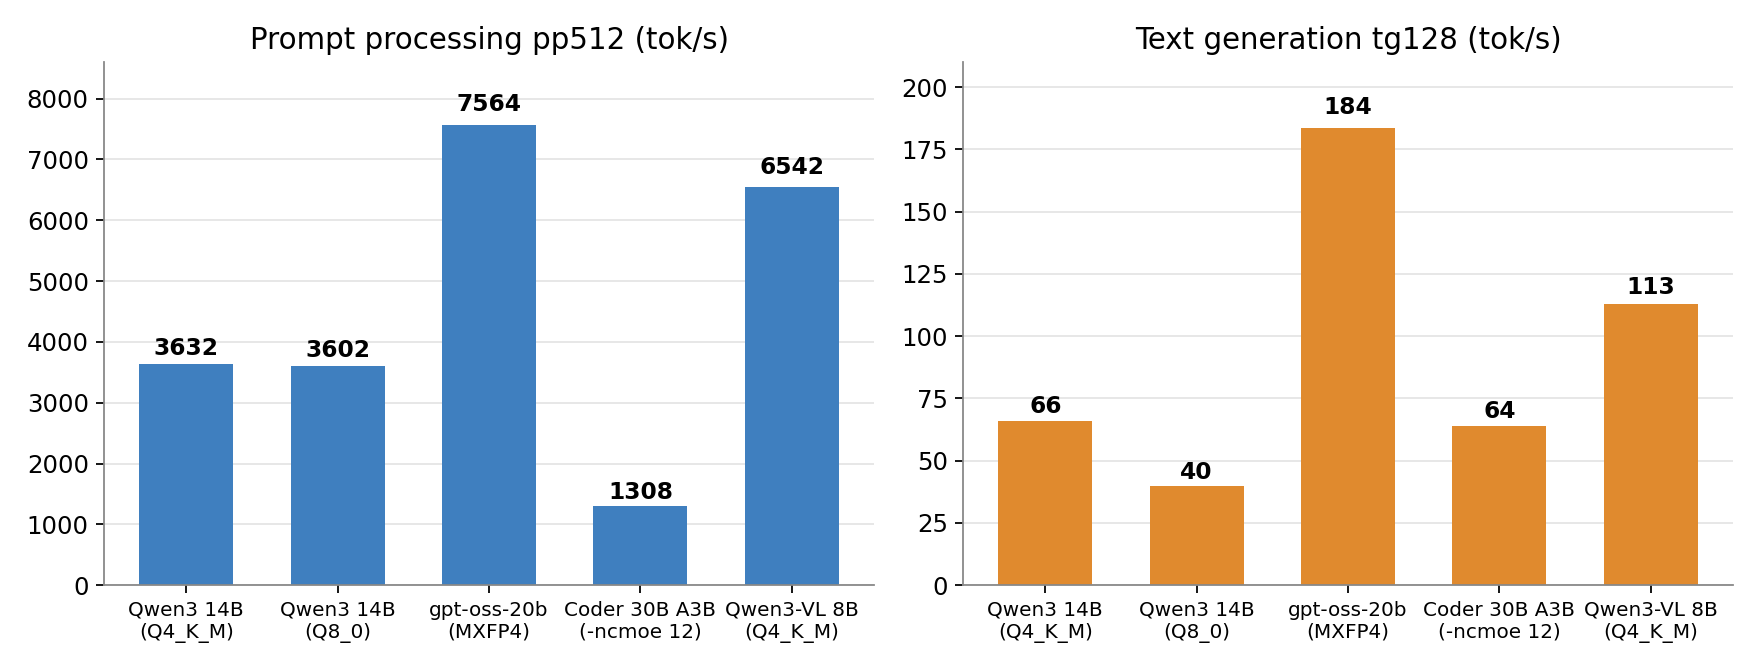
| モデル | pp512(tok/s) | tg128(tok/s) |
|---|---|---|
| Qwen3 14B Q4_K_M | 3632.48 | 65.74 |
| Qwen3 14B Q8_0 | 3602.00 | 39.75 |
| gpt-oss-20b MXFP4 | 7564.17 | 183.51 |
| Qwen3-Coder 30B A3B(-ncmoe 12) | 1308.22 | 63.84 |
| Qwen3-VL 8B Q4_K_M | 6542.12 | 112.77 |
読みどころは 3 つです。
1 つ目は、gpt-oss-20b の速さです。pp・tg ともに最速で、特に生成速度 183.51 tok/s は 2 位の Qwen3-VL(112.77)の約 1.6 倍あります。20B 級でも MoE で実際に働くパラメータが小さいことの恩恵が、そのまま数字に出ました。
2 つ目は、量子化の代償です。同じ Qwen3 14B でも、Q8_0 はプロンプト処理こそ Q4_K_M とほぼ互角なのに、生成速度は 39.75 tok/s と約 6 割に落ちます。生成は 1 トークンごとにモデル全体を読み直す処理なので、ファイルが重いほどメモリ帯域の差が効いてくる、という教科書どおりの結果でした。
3 つ目は、Qwen3-Coder の形です。プロンプト処理は 1308.22 tok/s と最も遅い一方、生成は 63.84 tok/s と Qwen3 14B Q4_K_M に迫る水準を保っています。部分オフロードの影響は主に「読み込みの速さ」に出て、生成そのものは意外と健闘する、というのが実測の印象です。
VRAM の結果 ― 16GB に収まるかは「条件次第」
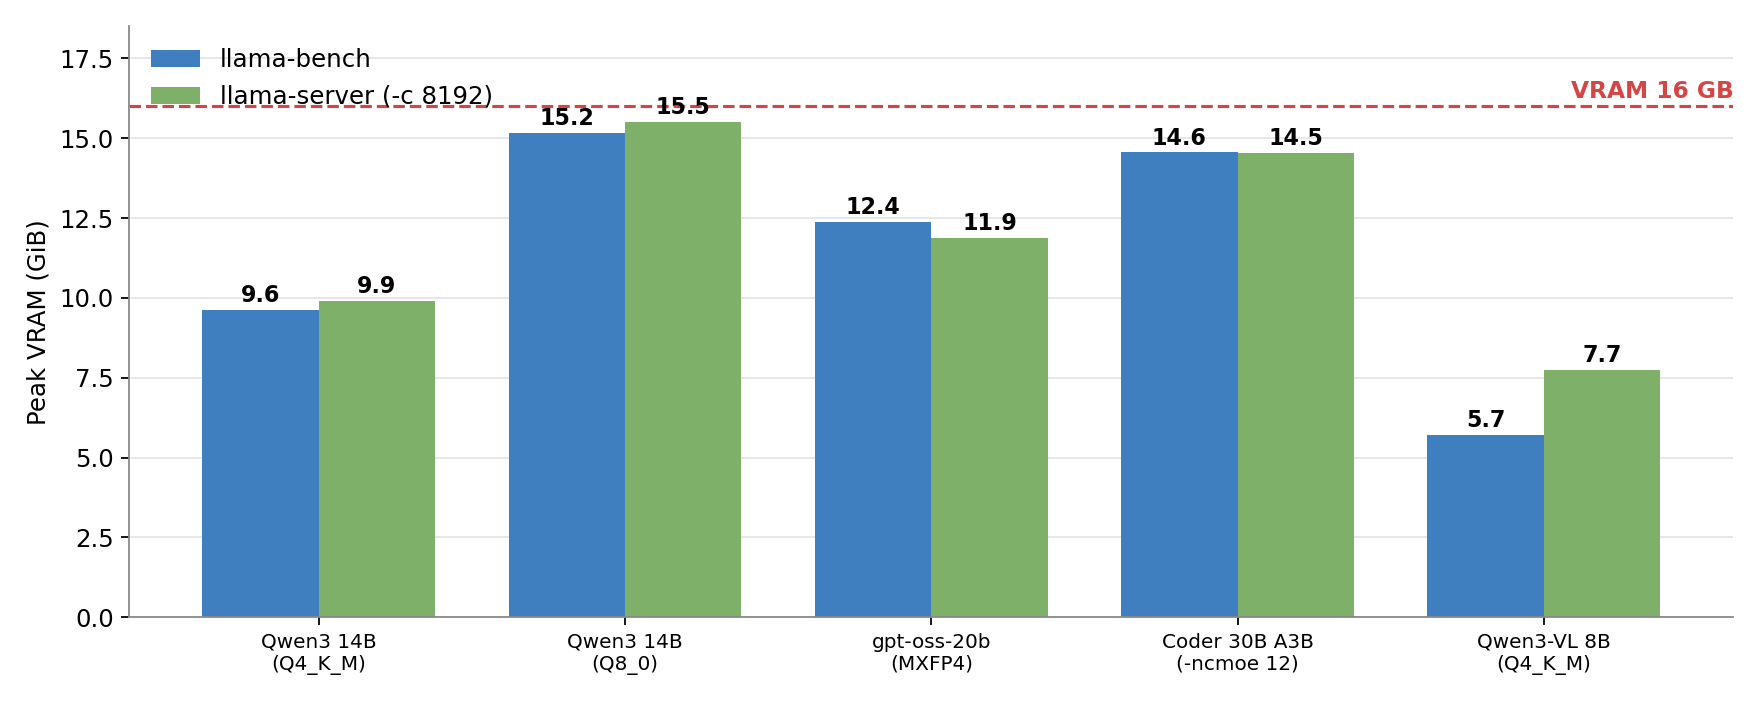
llama-benchによるベンチマーク時と、llama-serverで実際にサーバーとして使う場面(コンテキスト 8192)に分けて測りました。
| モデル | ベンチ時ピーク | 8K サーバー時ピーク |
|---|---|---|
| Qwen3 14B Q4_K_M | 9,858 MiB | 10,152 MiB |
| Qwen3 14B Q8_0 | 15,540 MiB | 15,868 MiB |
| gpt-oss-20b | 12,658 MiB | 12,169 MiB |
| Qwen3-Coder 30B A3B | 14,901 MiB | 14,882 MiB |
| Qwen3-VL 8B | 5,847 MiB | 7,916 MiB(画像入力込み) |
一番の注意点は Qwen3 14B Q8_0 です。8K サーバー時のピークは 15,868 MiB で、16GB(16,376 MiB)に対する空きは約 508 MiB しかありません。今回の計測では最後まで動きましたが、コンテキストを伸ばしたり、ブラウザなど他のアプリと併用したりすると簡単に破綻する綱渡りの状態です。「16GB で Q8_0 が動くか」という問いへの答えは、「動く。ただし余裕はほぼない」になります。
Qwen3-Coder の -ncmoe 12 は、値を変えながら測った結果から決めました。ncmoe は「MoE の専門家レイヤーを何層まで CPU に逃がすか」の指定で、24 から 12 に下げたところで生成速度が 48.30 から 67.51 tok/s に跳ね上がる「崖」がありました。12 では VRAM の空きも約 1.4GB 確保できたため、これを正式条件にしています。
Qwen3-VL は、画像入力を伴うサーバー時が 7,916 MiB と、テキストのみのベンチ(5,847 MiB)から約 2GB 増えました。画像用の mmproj と画像処理の分は、VRAM の見積もりにあらかじめ入れておく必要があります。
逆に Qwen3 14B Q4_K_M は、8K サーバー時でも空きが約 6GB あります。この余裕が、後の結論で「16GB 環境の本命」とする理由のひとつです。
ロード時間
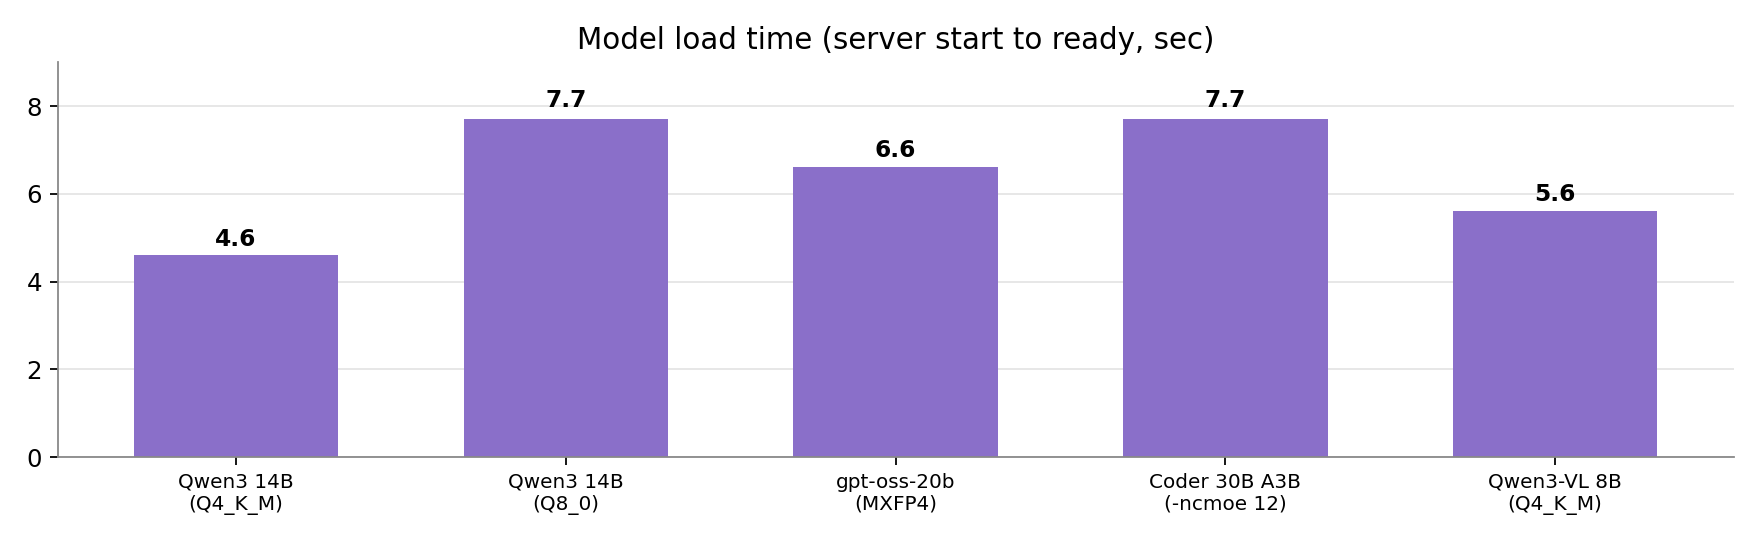
サーバー起動から応答可能になるまでの時間も測りました。
| モデル | ロード時間 |
|---|---|
| Qwen3 14B Q4_K_M | 4.6 秒 |
| Qwen3 14B Q8_0 | 7.7 秒 |
| gpt-oss-20b | 6.6 秒 |
| Qwen3-Coder 30B A3B | 7.7 秒 |
| Qwen3-VL 8B | 5.6 秒 |
どれも数秒で、ファイルサイズなりの素直な順序でした。日常利用でストレスになる水準ではありません。
品質確認 ― 速さでは分からない「性格」が出た
品質確認では、全モデルに同じ 4 つのプロンプトを投げました。設計は次のとおりです。
- P1 要約: 数字の多い文章を「3 文以内・200 字以内」で要約させる。数字を落とさず残せるかを見る
- P2 コード: 重複を取り除く Python 関数を書かせる。型ヒント・docstring・使用例つき
- P3 論理パズル: ラベルの貼り間違いの箱から中身を当てる古典問題。答えが 1 通りに決まる
- P4 長文指示: 見出し 2 つ、箇条書き 3 点ちょうど、指定した単語を全体で 1 回だけ、など複数の制約を同時に課す
採点は、文字数や単語の出現回数といった機械的に数えられる条件を実際に数え、P2 のコードは手元で実行して、本当に動くかまで確かめました。なお、使ったプロンプトの全文は以下の通り。P1〜P4 は温度 0 で全モデル共通です。デフォルト温度は、温度は指定せず、各モデルの既定値で実行しました。
- P1:要約
- P2: コード
- P3: 論理パズル
- P4: 長文指示
- デフォルト温度
- 画像(Qwen3-VLのみ)
次の文章を、重要な数字を落とさずに、3文以内・200字以内で要約してください。
横浜市は2027年4月、市中央図書館のリニューアルオープンを発表した。改修工事は2025年10月から17か月かけて行われ、総事業費は約48億円。改修の中心は3つある。第1に、蔵書スペースを従来の1.4倍に拡張し、開架冊数を32万冊から45万冊に増やした。第2に、3階に120席の学習室を新設し、うち40席は予約制の個室ブースとした。第3に、1階にカフェと子ども向けの読み聞かせスペースを併設し、開館時間を平日は午前9時から午後9時まで、土日祝日は午前9時30分から午後6時まで延長した。市は、年間の来館者数が改修前の約78万人から110万人に増えると見込んでいる。一方で、駐車場は改修前と同じ85台分しかなく、市は公共交通機関の利用を呼びかけている。
Pythonで、リストを受け取り、重複する要素を取り除いて元の順序のまま返す関数 unique_items(items) を書いてください。条件は次のとおりです。
・型ヒントとdocstringを付けること
・集合(set)を使ってよいが、順序が保たれること
・最後に、使用例とその実行結果を示すこと
3つの箱があります。ラベルにはそれぞれ「金貨だけ」「銀貨だけ」「金貨と銀貨」と書かれていますが、すべてのラベルは間違っています。中身は、金貨だけの箱、銀貨だけの箱、金貨と銀貨が混ざった箱が1つずつです。どれか1つの箱から硬貨を1枚だけ取り出して見ることで、すべての箱の中身を確定できます。どの箱から取り出すべきか、そして取り出した硬貨が金貨だった場合、各箱の中身がどう確定するか、順を追って説明してください。
在宅勤務のメリットについて、次の条件をすべて守って書いてください。
(1) 全体を2つの見出し「## メリット」「## 注意点」で構成すること
(2) 「## メリット」の下には箇条書きでちょうど3点挙げ、各項目は40字以内にすること
(3) 「通勤」という言葉を、全体で必ず1回だけ使うこと
(4) 最後は、注意点をふまえた一文の結論で締めること
(5) 全体で400字以内にすること
今度の週末、丸一日フリーになりました。家の中でできる、あまりお金のかからない面白い過ごし方を3つ提案してください。それぞれ、所要時間の目安も添えてください。
この画像に写っているものを詳しく説明してください。数えられるものがあれば個数も教えてください。
P1 要約
主要な数字を保ったまま条件内でまとめたのは Qwen3-Coder です。Qwen3-VL は駐車場の台数まで含めて数字が最も網羅的でしたが、5 文に分かれて文数の条件を超えました。gpt-oss は数字を全項目残した唯一の回答だったものの、225 字で字数オーバーです。Qwen3 14B の 2 つは後述する追試で完走し、数字はほぼ網羅できましたが、文数は 4〜5 文と条件には届きませんでした。要約は「情報を落とさないこと」と「型に収めること」の両立が難しく、モデルごとの得意・不得意が分かれる設問でした。
P2 コード
最終的には全モデルが、正しく動作するコードに到達しました。gpt-oss、Qwen3-Coder、Qwen3-VL は初回で完成し、実行検証でも全テストを通過しています。Qwen3 14B の 2 つは追試で完成しました(事情は次の章で説明します)。書き方の個性はありましたが、少なくとも今回の難易度では「コードが書けないモデル」はありませんでした。
P3 論理パズル
gpt-oss と Qwen3-Coder が初回で完全正解です。Qwen3 14B の 2 つも追試では正解に到達しました。一方、Qwen3-VL は推論の途中で同じ文を繰り返すループに入ってしまい、結論に届きませんでした。テキスト生成では優秀なモデルが、論理の組み立てでつまずく例として、そのまま記録しておきます。
P4 長文指示
複数の制約をすべて満たしたのは、Qwen3-Coder だけでした。実際の回答は次のとおりです。
## メリット
・通勤時間の削減でリラックスできる
・作業環境の自由な調整が可能
・時間管理がしやすく、効率が向上
>
## 注意点
・集中力の維持が難しい場合がある
・コミュニケーションが不足しやすい
・仕事と生活の境界が曖昧になることがある
>
在宅勤務はメリットも多いが、自発的な管理が重要である。
対照的に、Qwen3 14B の 2 つと Qwen3-VL は、揃って「『通勤』を全体で 1 回だけ」という条件に落ちました。3 件とも箇条書きの中では 1 回に抑えていたのに、締めの一文でもう 1 回書いてしまったのです。人間でもやりそうなミスですが、制約の数え落としが起きやすい場所はモデル共通らしい、というのは面白い発見でした。
デフォルト温度のサンプルと、画像の読み取り
条件を付けずに「週末の過ごし方を 3 つ」と聞くサンプルでは、5 モデルとも所要時間の目安つきで無難に答えました。日常の雑談用途では、どのモデルも大きな差は感じません。
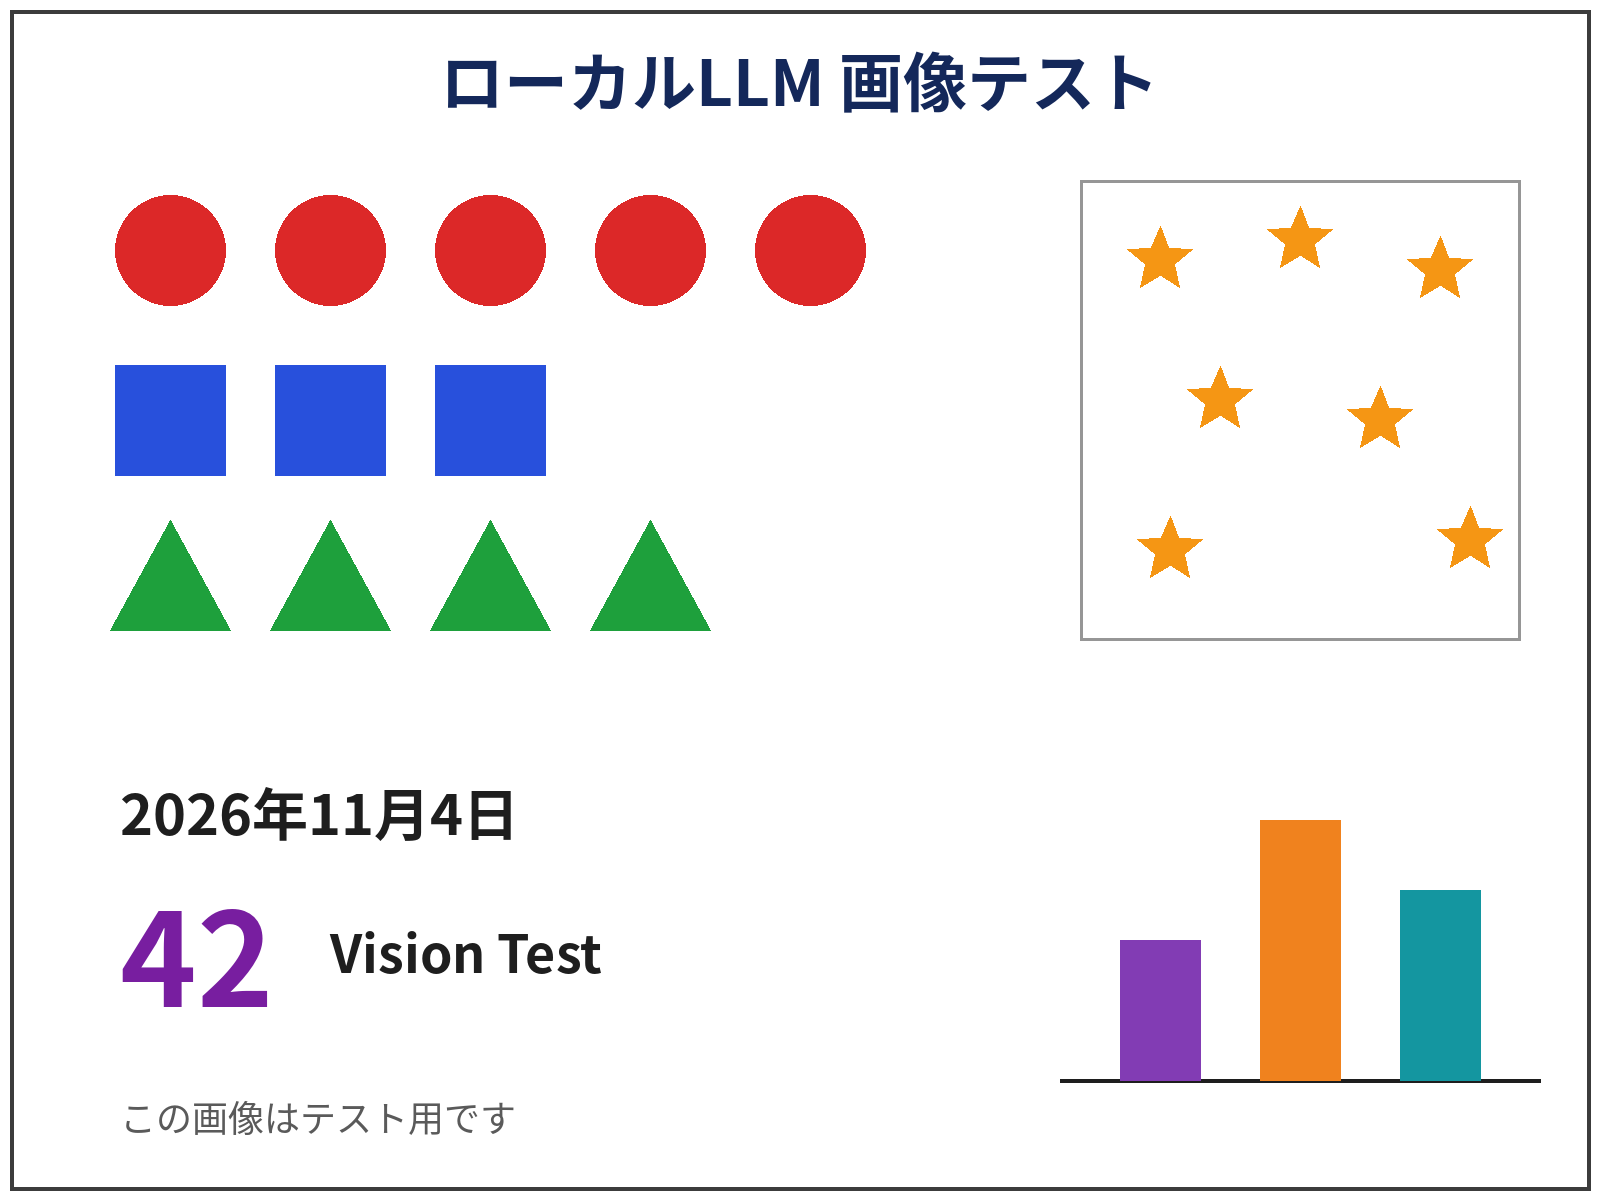
Qwen3-VL の画像読み取りには、図形の個数や文字を正確に数えられる専用のテスト画像を用意しました。
結果はほぼ完璧です。赤い円 5 個、青い四角 3 個、緑の三角 4 個、オレンジの星 7 個という個数をすべて当て、タイトルや日付、大きな数字「42」といった文字も読み取り、棒グラフで一番高いのが中央の棒であることまで正しく答えました。唯一の相違は、星の色を「黄色」と表現した点くらいです。
追試について
初回の品質確認では、生成トークンの上限(max_tokens)の設定が小さすぎました。思考過程の長いモデルでは、考え終わる前に上限へ達してしまい、回答が途中で途切れたのです。特に Qwen3 14B の 2 つは、要約が 1 文の断片だけ、論理パズルの回答が書き出し数十字だけ、という状態で記録されてしまいました。
そこで、プロンプトは完全に同一のまま、上限だけを広げた追試を行いました。結果、Qwen3 14B の 2 つは全プロンプトを完走し、コードは実行検証も通過、論理パズルも正解に到達しました。本文中の Qwen3 14B に関する品質評価は、この追試の結果に基づいています。
一方で、gpt-oss の P4 は追試でも完結しませんでした。全条件を満たす下書き(355 字)自体は作れていたのですが、その後に文字数を数える自己検証の思考が長引き、制限の中で最終回答として届かなかったのです。これは設定の問題ではなく、このモデルの振る舞いの特徴として記録しておきます。「間違える」のではなく「検証に時間を使いすぎる」タイプの失敗でした。
なお、思考型のモデルでは、思考過程がそのまま出力に現れる場合がありました。llama.cpp のチャットテンプレートや推論設定によって挙動が変わる部分なので、使う側でも「思考にどれだけトークンを割くか」は意識しておく必要があります。
結論 ― 16GB 環境でのおすすめ
| モデル | 量子化 | VRAM(GiB) | pp512 | tg128 | 判定 |
|---|---|---|---|---|---|
| Qwen3 14B | Q4_K_M | 9.63 | 3632.48 | 65.74 | ◎ 快適 |
| Qwen3 14B | Q8_0 | 15.18 | 3602.00 | 39.75 | ○ 良い |
| gpt-oss-20b | MXFP4 | 12.36 | 7564.17 | 183.51 | ◎ 快適 |
| Qwen3-Coder 30B A3B | Q4_K_M / 部分オフロード(-ncmoe 12) | 14.55 | 1308.22 | 63.84 | △ 条件付き |
| Qwen3-VL 8B | Q4_K_M | 5.71 | 6542.12 | 112.77 | ◎ 快適 |
※ Qwen3-Coder の判定 △ は速度の問題ではなく、部分オフロードが必須であるためです。VRAM はベンチ時のピーク値です。
用途別にまとめると、次のようになります。
- 迷ったら Qwen3 14B Q4_K_M。速度・VRAM・品質のバランスが最も良く、8K コンテキストでも約 6GB の余裕があります
- 応答の速さを最優先するなら gpt-oss-20b。生成 183.51 tok/s は別格です。ただし、厳密な長文指示では自己検証に生成を使いすぎる場面がありました
- コード用途なら Qwen3-Coder。部分オフロード必須で読み込みは遅いものの、生成速度は実用水準で、今回の品質確認では最も堅実な回答を返しました
- 画像も扱いたいなら Qwen3-VL。軽くて速く、画像認識の精度も高い、守備範囲の広い 1 つです
- Qwen3 14B Q8_0 は、今回の範囲では Q4_K_M との品質差がほぼ見られませんでした。その一方で VRAM は限界近く、生成速度は約 6 割に落ちます。16GB 環境では、量子化を上げる恩恵より代償のほうが大きい、というのが実測の結論です
まとめ
VRAM 16GB でも、今回の 5 モデルはすべて実用速度で動きました。差が出たのは速度そのものよりも、VRAM の余裕と、指示への従い方や思考の進め方といった「回答の性格」の部分の違いが見えたかなと思います。
※ 本記事の数値は 2026 年 11 月 4 日時点の計測です。llama.cpp やモデルのバージョンが変われば結果も変わります。