「VRAM 12GB級で125Bのモデルが動く」という触れ込みの推論エンジン Strata を、RTX 4070 Ti Super(VRAM 16GB)と RAM 64GB の環境で実測しました。量子化の異なる3つのセットで、速度・メモリ・回答品質・API連携までを確かめています。
計測の前提と方法
まず、前提条件から。
| 項目 | 内容 |
|---|---|
| GPU | RTX 4070 Ti Super(VRAM 16GB) |
| CPU | AMD Ryzen 9 9950X |
| メモリ | 64GB |
| ストレージ | Crucial T700 1TB Gen5 NVMe M.2 SSD |
| OS | Windows 11 Pro (26H2) |
| Strata | 0.2.13/エンジン 0.1.59 |

計測方法は次のとおりです。
- 速度は Strata の OpenAI 互換 API 経由で固定プロンプトを投げ、応答の記録から算出しました。各条件3回、中央値を採用しています
- 入力の長さは「短文」と「32Kトークン入力」の2段です。コンテキスト長の設定上限はデフォルトの 131,072 のまま下げていません
- 32K 入力は、回ごとに中身の違うプロンプトを使いました
- TTFT は「最初のトークンが出るまでの時間」です。このモデルは推論過程を先に生成するため、TTFT には推論の開始までを含み、本文が始まるまでの時間は別に記録しました
- VRAM は生成中のピークを nvidia-smi で1秒間隔に記録、RAM はシステム全体のピークを記録しました(RAM は他プロセスの影響も受けるため、参考値として扱ってください)
- 品質確認は、プロンプト4題を温度0で投げました。生成上限は思考型モデル向けに 8,192 トークンへ引き上げています
prefill と生成速度について
- prefill(読み込み): 入力した文章を処理する段階です。長い文章を投げたとき、返事が始まるまでの待ち時間に影響します
- 生成速度: 回答を1秒に何トークン出せるかです。返事が流れてくる速さの体感に直結します
この記事では、32K入力の prefill 速度を「入力トークン数 ÷ 最初のトークンまでの時間」で算出しています。
Strataについて
Strata は、GitHub で公開されているオープンソースの推論エンジンです(Niko1221/Strata)。2026年9月に v0.1.0 が公開され、その後の更新は非常に速く、本記事の計測版は 0.2.13(エンジン 0.1.59)です。数週間でがらっと環境や流行りが変わったりしてきていて、技術の進歩ってすごいなと。
最大の特徴は、対象モデルが実質的に Qwen3.8-Flash-Next 系に絞られていることです。llama.cpp が「何でも動く汎用エンジン」なのに対し、Strata は「1つのモデルを家庭用GPUで動かすためだけに最適化し切った専用エンジン」という位置づけです。llama.cpp/ggml 系の技術を基にしながら、モデルの構造に合わせた専用の仕組みを重ねています。
デスクトップアプリ版が公開されて久しいので、もはやそちらが多数派かと思いまして、今回はデスクトップアプリ版で進めていきます。
なぜ12GBで125Bが動くのか ― MoEと4層構造
鍵は MoE(Mixture of Experts、専門家の混合)という構造です。Qwen3.8-Flash-Next は総パラメータ約125Bを持つ一方、1トークンの生成で実際に使う「専門家(Experts)」は、全24,576個のうち約10個だけです。活性化する規模は約6B相当とされ、「125B全部を毎回計算する」わけではありません。
それでも専門家の総量は巨大なので、置き場所を分ける必要があります。Strata は次の4層に分散させます。
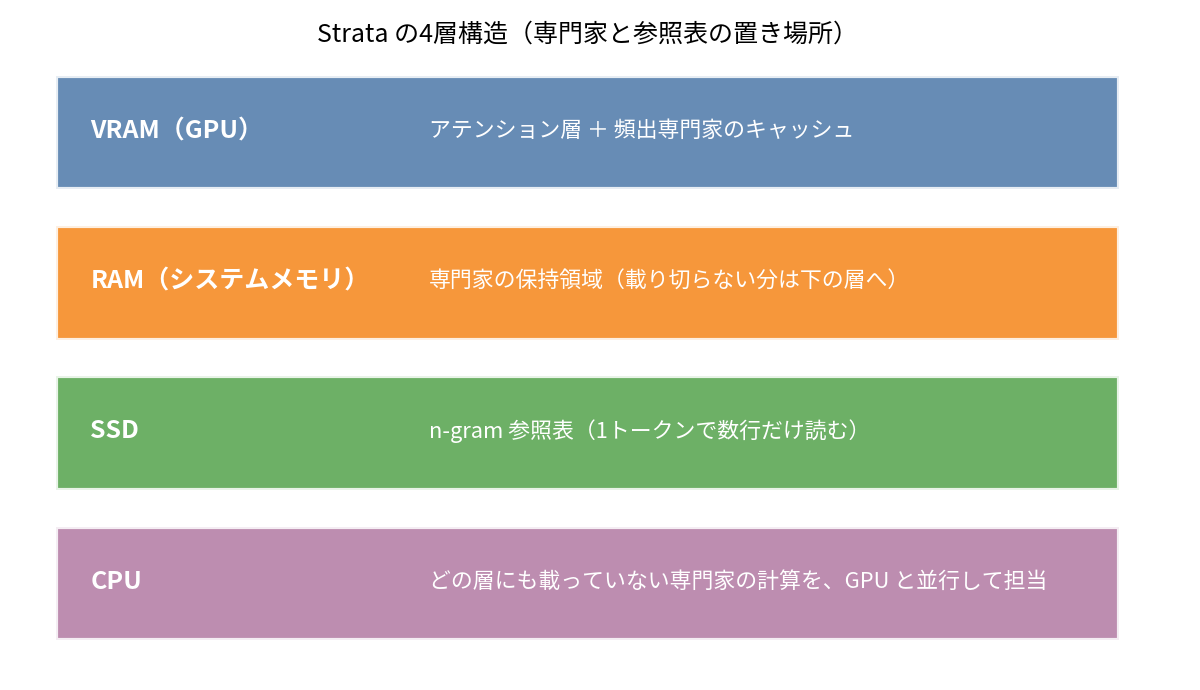
- VRAM: アテンション層と、よく使う専門家のキャッシュ
- RAM: 専門家の保持領域。エンジンのログでは、専門家の総量は約46.8GiBと表示されました
- SSD: n-gram 参照表。1トークンで数行だけ読むため、SSD の速度でも間に合う設計です
- CPU: どの層にも載っていない専門家の計算を、GPU と並行して担います
実際に IQ3_S のエンジンログを見ると、約46.8GiB の専門家のうち 26.7GiB 分は RAM にも載り切らず、生成のたびにファイルから読まれていました。「VRAMに収めた」のではなく「VRAMの外を速くした」というのが正確な理解です。だからこそ、VRAM の大きさよりも RAM の容量と、ストレージの読み出し速度が影響します。
コンテキスト長が安いのも、このモデルの構造によるものです。全48層のうち36層は線形アテンションで、状態の大きさが入力長に比例して増えません。通常のアテンション側も、参照する KV は2,048トークン分に絞られます。llama.cpp の「コンテキストを上げるほど VRAM を食う」図式が当てはまらないため、設定上限 131,072 のままでも VRAM が破綻しません。
計測に使用するモデル
「125Bが動く」の主語を正確にしておきます。
第一に、ダウンロードするファイルには、モデルの重みに加えて n-gram 参照表が含まれます。今回の IQ3_S では、重み約54.8GB+参照表約28.8GBで、合計 83.6GB でした。「モデル本体の大きさ」と「ディスクに必要な容量」は一致しません。
第二に、速さの数字は量子化の強さとセットです。2bit級の軽い量子化ほど速く・荒く、4bit級はその逆です。本記事で測るのは次の3セットです。
| セット | 系統 | 容量 | この環境での位置づけ |
|---|---|---|---|
| IQ3_S | ISTA-DASLab(GSQ系) | 83.6GB | 公式ガイドで最上位とされるセット。軸として採用 |
| UD-IQ3_XXS | Unsloth Dynamic v3.1 | 83.6GB | IQ3_S と同容量。量子化方式の違いを比べるため採用 |
| UD-IQ4_XS-v31 | Unsloth Dynamic v3.1 | 93.7GB | 4bit級。専門家が RAM に載り切らず、SSD からの読み出しが増える前提 |
量子化の提供元は2系統あります。ISTA-DASLab の GSQ 系は従来からの本命で、Unsloth 系は 2026年11月に「Dynamic v3.1」として再アップロードされたものです。どちらかが他方を置き換えたわけではなく、同じモデルの別供給という関係にあります。記事では「どの系統の、どのセットを測ったか」を必ず併記します。
第三に、RAM の条件です。公式要件は RAM 32GB 以上ですが、選べる量子化は容量で変わり、64GB で全サイズが現実的になります。ディスクも、セット1つで 80〜94GB 相当の空きが必要です。
実測
短文入力
まず通常の対話に近い、短い入力での結果です。
| セット | TTFT | 生成速度 | 総時間 | 本文開始まで |
|---|---|---|---|---|
| IQ3_S | 0.31秒 | 20.35 tok/s | 28.9秒 | 20.89秒 |
| UD-IQ3_XXS | 0.31秒 | 20.50 tok/s | 47.5秒 | 39.49秒 |
| UD-IQ4_XS-v31 | 0.32秒 | 17.10 tok/s | 94.6秒 | 82.41秒 |
生成速度だけ見ると IQ3_S と UD-IQ3_XXS が互角で、UD-IQ4_XS-v31 が一歩落ちます。ところが総時間は大きく開きました。理由は「考える量」の違いです。同じプロンプトでも、推論に使うトークン数がセットで違いました(生成トークンの中央値で、IQ3_S が583、UD-IQ3_XXS が967、UD-IQ4_XS-v31 が1,594)。tok/s が同じでも、考え込む量が2倍なら待ち時間も2倍になります。「速さ」は tok/s だけでなく、推論の長さ込みで見る必要がある、というのが短文計測の一番の学びです。
32K入力
次に長文入力です。約32,000トークンの文書を読ませ、冒頭の章について質問しました。
| セット | prefill速度 | TTFT | 生成速度 | VRAMピーク | RAMピーク |
|---|---|---|---|---|---|
| IQ3_S | 約1,065 tok/s | 30.16秒 | 15.22 tok/s | 15,701MiB | 約36.1GiB |
| UD-IQ3_XXS | 約1,247 tok/s | 25.75秒 | 23.22 tok/s | 15,926MiB | 約41.5GiB |
| UD-IQ4_XS-v31 | 約1,014 tok/s | 31.66秒 | 18.30 tok/s | 15,886MiB | 約39.0GiB |
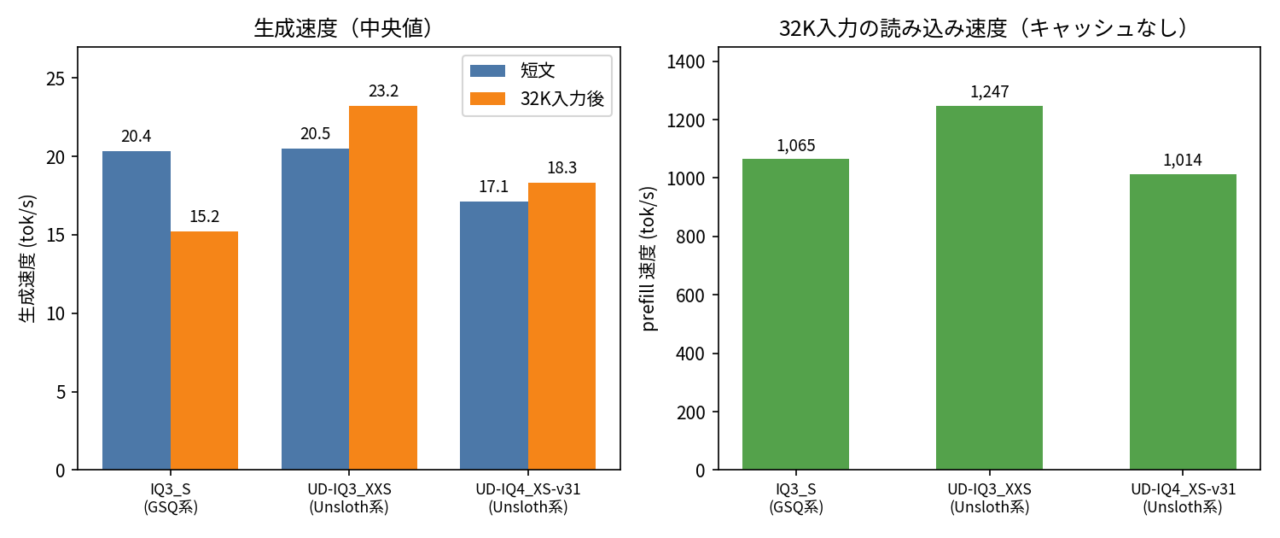
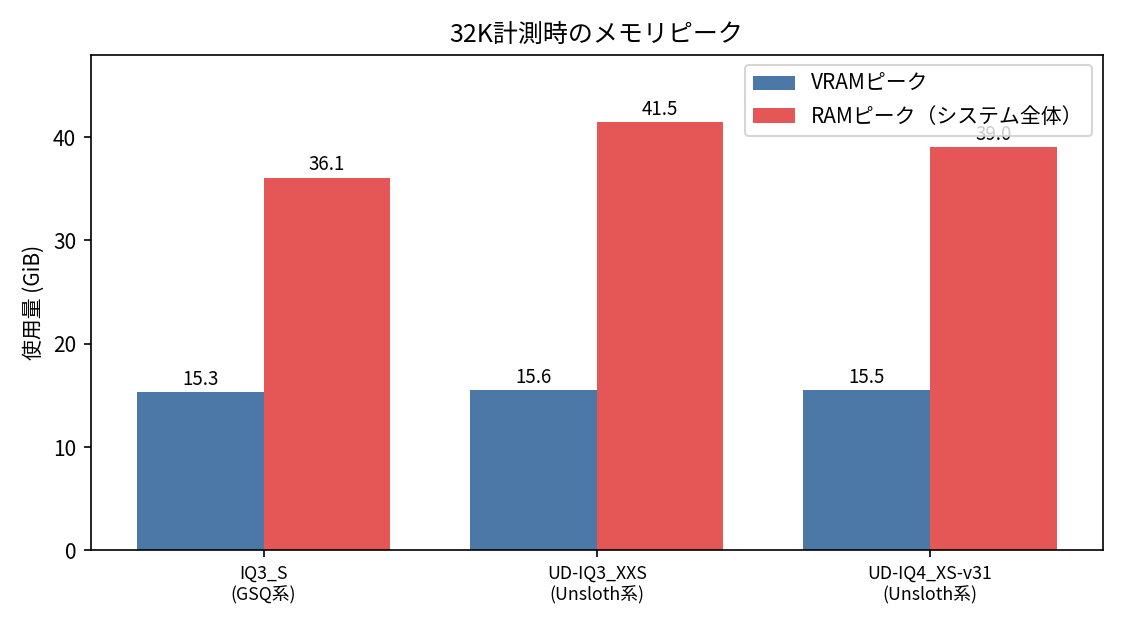
読み込みは3セットとも約1,000 tok/s以上で、32Kトークンの入力でも25〜32秒で読み終わります。生成速度は UD-IQ3_XXS が 23.22 tok/s と頭一つ抜け、同容量の IQ3_S(15.22 tok/s)を明確に上回りました。ドラフター(投機的デコーディングの補助モデル)の選択は3セットとも同じ条件(DFlash2、信頼度しきい値0.7)だったため、この差は量子化方式そのものの差と考えられます。
UD系の2セットでは「32K入力後の生成速度」が「短文の生成速度」を上回っています。短文では話題が移るたびに多様な専門家を読みに行く場面が多いのに対し、長文では読み込んだ専門家の範囲で生成が進むためではないか、というのが現時点の見立てです。ただし、これは観測からの推測で、断定はしません。
VRAM は3セットとも約15.5GiBで、16GBの上限に張り付きます。RAM は 36〜41GiB台(システム全体のピーク)でした。なお、32K文書の内容についての質問(文書冒頭の数値・固有名詞の検索)には、3セットとも全問正解しています。長文を「読める」だけでなく「使える」ことは確認できました。
品質確認
以前使用した共通プロンプト4題を、3セットすべてに温度0で投げました。採点は、文字数や単語の出現回数といった機械的に数えられる条件を実際に数え、P2のコードは手元で実行して検証しています。
| セット | P1 要約 | P2 コード | P3 論理 | P4 長文指示 |
|---|---|---|---|---|
| IQ3_S | ○ | ○※ | ○ 正解 | ○ 全条件達成 |
| UD-IQ3_XXS | △ | ○ | ○ 正解 | △ |
| UD-IQ4_XS-v31 | ○ | ○※ | ○ 正解 | △ |
※P2のコード自体は全セットとも実行検証を通過。ただし IQ3_S と UD-IQ4_XS-v31 は、説明文(docstring)が中国語になっていました
P1 要約
数字の多い文章を「3文以内・200字以内」で要約させる設問です。IQ3_S と UD-IQ4_XS-v31 は、主要な数字をすべて残したまま条件内に収めました。IQ3_S の文章は読点でつないだ電文体で、読みやすさには欠けます。一方、UD-IQ3_XXS は数字こそ全網羅でしたが4文に分かれ、文数の条件を超えました。第2弾でも「情報を落とさないこと」と「型に収めること」の両立でモデルが分かれた設問で、今回も同じ構図です。
P2 コード
重複を取り除く Python 関数を書かせる設問です。3セットとも正しく動作するコードに到達し、実行検証(空リストなどの端ケースを含む)も全て通過しました。差が出たのは言語で、IQ3_S と UD-IQ4_XS-v31 は docstring が中国語でした。日本語で統一できたのは UD-IQ3_XXS だけでした。
P3 論理パズル
ラベルの貼り間違いの箱から中身を当てる古典問題です。3セットとも正解し、説明の筋も通っていました。
P4 長文指示
見出し2つ、箇条書き3点ちょうど、各40字以内、指定した単語(「通勤」)を全体で1回だけ、最後は一文の結論で、という複数制約の同時達成を見る設問です。全条件を満たしたのは IQ3_S だけでした。第2弾で全条件を満たしたのは Qwen3-Coder だけで、他のモデルは「通勤を2回書く」ミスで落ちました。今回の UD 2セットは、箇条書きと単語の回数は守れたものの、注意点の書き分けで落としています(UD-IQ3_XXS は注意点の記述自体がなく結論だけ、UD-IQ4_XS-v31 は注意点と結論が一文に融合)。125B級でも、制約の同時達成は一筋縄ではいかない、という結果です。
全体を通して
品質の大差はつかなかったかなと。4bit級の UD-IQ4_XS-v31 が品質で明確に勝つ場面は、この4題においては現れませんでした。差が出たのは、速度と「考える量」と、指示への厳密さの配分です。
もう1つ、待ち時間の実態も書いておきます。P1のような短い回答でも、3セットとも約6,000トークンの推論を回し、回答までに100〜320秒かかりました。答えが短くても、考える時間が支配的になるのが思考型モデルの性格です。
デフォルト温度のサンプル(日本語の自然さを見る1題)は、3セットとも自然な日本語で条件を満たしました。IQ3_S は 4,000字超とかなり長めの回答でした。
VScodeの拡張機能Clineから使ってみる
ほぼおまけ要素。Strata は API を公開しているので、今回は VS Code の拡張機能 Cline で試しました。
接続は OpenAI Compatible プロバイダを選び、Base URL に http://127.0.0.1:(ポート番号)/v1を入力しStrataで現在起動しているモデルを選びます。URLはStrataウィンドウ左下にあるその他から配信を押して確認してください。今回はCline設定のModel Configurationにて、他計測と合わせる意図もありコンテキスト長 131,072 と出力上限 8,192を設定しました。
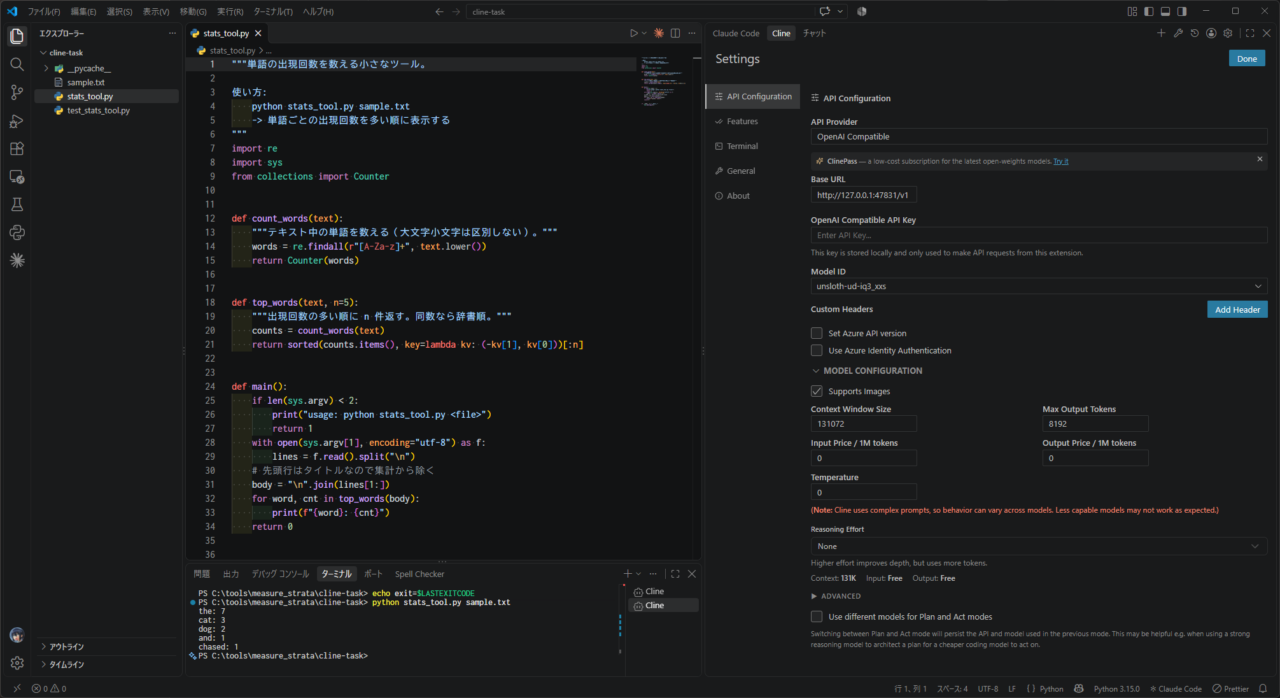
使うセットは なんとなくUD-IQ3_XXS にしました。タスクは、「バグ入りの小さな Python ツール(単語数カウンタ)を、テストが通るように直す」というものです。
結果は、テスト全通過で完了しました。修正は1行だけで、余計な変更もテストファイルの改変もありませんでした。修正後のファイルを手元でも実行し直し、テスト全通過とサンプル出力の一致を別途確認しています。
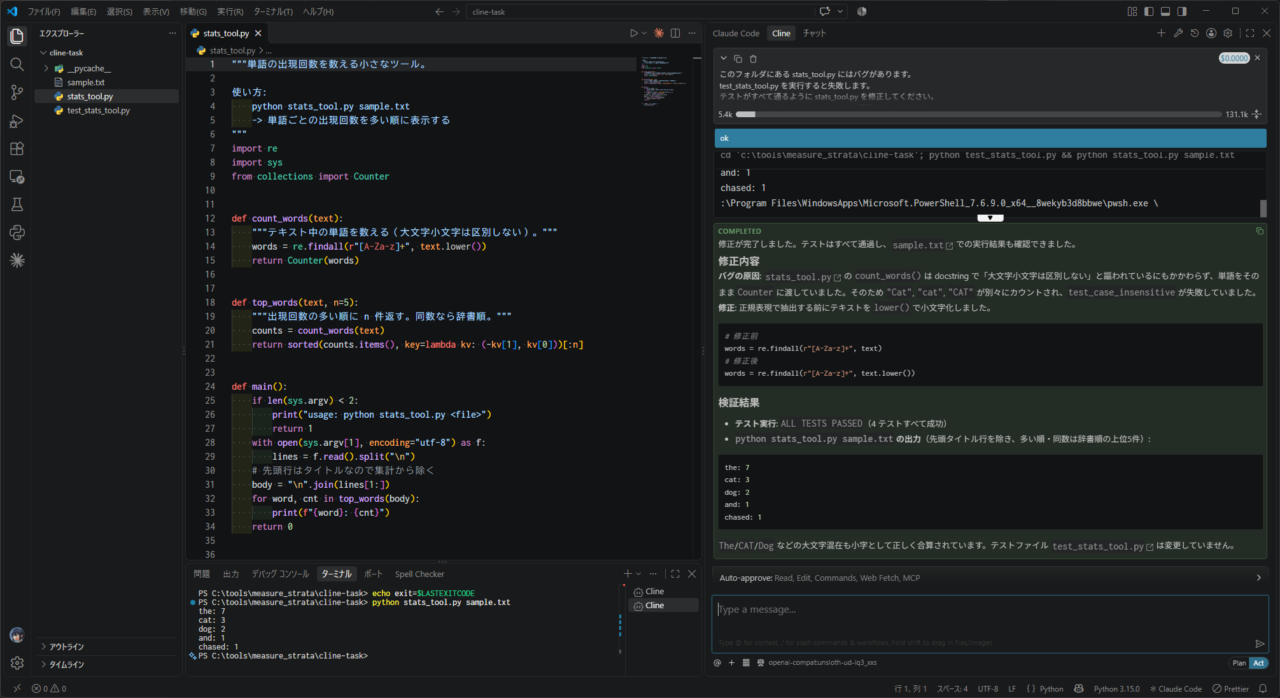
このタスクで使ったコンテキストは 5.4K/131.1K で、4%程度でした。
結局Strataってどうなの
向いてる人:
- RAM 64GB級を積んでいて、最大級のモデルを手元で触りたい人
- コーディング支援などをローカルで回したい人(API接続が前提の使い方)
- 長い文書を丸ごと読ませる用途がある人
向いてない人:
- RAM 32GB 未満の人(選べる量子化が大きく制限されます)
- モデルを頻繁に替えたい人(ほぼ1モデル専用です)
- 安定した枯れた環境が欲しい人(更新の速さは魅力でもあり、ことこの分野においては少数派かもしれませんが)
本当に進歩が早いので、今回の内容もすぐに古くさいものになっていくんでしょうね……もうブログ形態は向いていないのかも。